机器学习、统计分析、数据挖掘、神经网络、人工智能与模式识别的关系解析
在当今数据驱动的时代,机器学习、统计分析、数据挖掘、神经网络、人工智能和模式识别等术语频繁出现在学术研究、技术开发和商业应用中。许多人容易将它们混为一谈,但实际上它们既有区别又有紧密联系。本文将从概念定义、历史渊源和实际应用角度,梳理这六个领域之间的关系。
一、人工智能:最宽泛的上位概念
人工智能(Artificial Intelligence, AI)是最宏大的目标:让机器模拟、延伸乃至超越人类的智能行为,包括推理、学习、感知、规划、自然语言理解等。AI是 umbrella term(伞形术语),其他领域大多可视为实现AI的手段或子领域。
二、机器学习:AI的核心驱动力
机器学习(Machine Learning, ML)是实现AI的一种核心方法,指计算机从数据中自动学习规律,并用于预测或决策,而不需要显式编程。机器学习包括监督学习、无监督学习、强化学习等范式。它是AI的子集,也是当前AI复兴的主要推动力。
三、神经网络:机器学习的一种模型家族
神经网络(Neural Networks, NN)是受生物神经系统启发而设计的数学计算模型,由多层神经元组成。它是机器学习中的一类具体算法(如深度学习的核心)。神经网络属于机器学习,而机器学习又属于AI。
四、模式识别:从数据中找规律
模式识别(Pattern Recognition, PR)关注如何让机器对输入数据(如图像、声音、文本)进行分类或描述。传统上,模式识别与机器学习高度重叠,但更强调“模式”的发现与匹配。早期模式识别多用统计方法,现代模式识别则大量采用机器学习(尤其是神经网络)。可以说,模式识别是机器学习的重要应用领域,也是AI的经典分支。
五、统计分析:理论基础与方法论
统计分析(Statistical Analysis)是收集、整理、分析和解释数据的数学分支。它为许多领域提供理论基础:机器学习中的许多算法(如线性回归、贝叶斯分类)源自统计;统计推断用于评估模型显著性;数据挖掘中的关联规则也依赖统计度量。但统计更强调假设检验、置信区间和可解释性,模型可能不追求预测精度,而追求因果推断。
六、数据挖掘:从大数据中提取知识
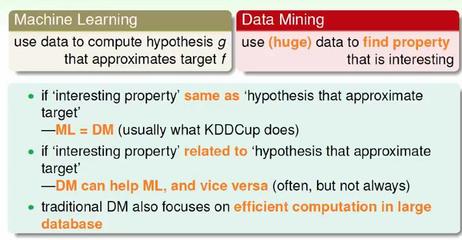
数据挖掘(Data Mining, DM)是从大规模数据集中发现未知、有价值模式的过程。它融合了机器学习、统计、数据库技术、信息检索等。数据挖掘通常被视为知识发现(KDD)的一个步骤。它利用机器学习算法(如决策树、聚类)和统计方法(如相关性分析)来完成任务。与机器学习相比,数据挖掘更偏重应用和商业价值,而非算法本身创新。
七、关系
可以用一个同心圆或层级图来表示:
- 最外层:人工智能(终极目标)
- 中间层:机器学习(实现AI的主要途径)
- 内层:神经网络(机器学习的一种模型)、模式识别(机器学习的经典应用)、数据挖掘(机器学习与统计的应用交叉)
- 基础支撑:统计分析(为多个领域提供理论工具)
具体而言:
- 人工智能包含机器学习;机器学习包含神经网络(以及非神经网络的模型,如SVM、决策树)。
- 模式识别与机器学习高度重叠,常被混用:传统模式识别侧重于特征提取+分类器,现在二者几乎等同。但模式识别可看作AI的一个早期分支。
- 数据挖掘是机器学习与统计分析在大型数据库上的应用,同时包含数据库管理、可视化等。数据挖掘会使用机器学习算法,但目标不是发明新算法,而是发现知识。
- 统计分析为机器学习、数据挖掘、模式识别提供理论基础(如概率分布、假设检验、回归分析),同时也用于评估这些模型。
- 神经网络是机器学习的一种强大工具,近年因深度学习而爆发,可应用于模式识别(如图像识别)和数据挖掘(如预测用户行为)。
八、收敛与趋势
随着大数据和算力提升,这些领域日益融合。例如,深度学习(神经网络)既是机器学习的子集,也是模式识别的现代方法,还被用于数据挖掘任务。统计学家参与机器学习研究,称其为“统计学习”。而人工智能则统筹这些技术,朝着通用智能迈进。
简言之:人工智能是目标,机器学习是手段,神经网络是利器,模式识别是经典应用,数据挖掘是知识发现过程,统计分析是理论基石。它们层层嵌套、相互促进,共同构成智能数据分析的生态体系。
如若转载,请注明出处:http://www.pdukun.com/product/33.html
更新时间:2026-09-25 10:43:59